Tes Adaptif Komputer: Cara Kerja dan Kapan Ia Lebih Baik
Tes adaptif memilih butir berikutnya berdasarkan jawaban sebelumnya. Hasilnya bisa jauh lebih efisien daripada tes tetap, tetapi ada syarat teknis yang jarang dijelaskan penyedia.
Ringkasan cepat
Tes adaptif memilih butir berikutnya berdasarkan jawaban sebelumnya. Hasilnya bisa jauh lebih efisien daripada tes tetap, tetapi ada syarat teknis yang jarang dijelaskan penyedia.
Coba tesnya sekarang — tanpa mendaftar
Profil lima dimensi kepribadian: yang stabil, yang bisa berubah, dan yang sering disalahpahami.
- Jawaban langsung dinilai di server
- Tanpa email, tanpa nama
- Laporan lengkap dibuka dengan akun
- Tersimpan 30 hari untuk Anda klaim
Hasil adalah bahan refleksi, bukan diagnosis. Untuk membaca dan menyimpan laporan, masuk atau daftar setelah tes selesai — hasil yang sudah dikerjakan tidak hilang.
Seorang peserta menutup sesi setelah 34 butir. Peserta di sebelahnya mengerjakan 62 butir pada alat yang sama. Keduanya menerima laporan dengan panjang serupa dan rentang ketidakpastian yang tidak jauh berbeda.
Jumlah soal yang berbeda itu bukan kerusakan sistem. Pada tes adaptif, panjang tes memang bervariasi antar peserta. Yang dijaga bukan jumlah butir, melainkan presisi hasil.
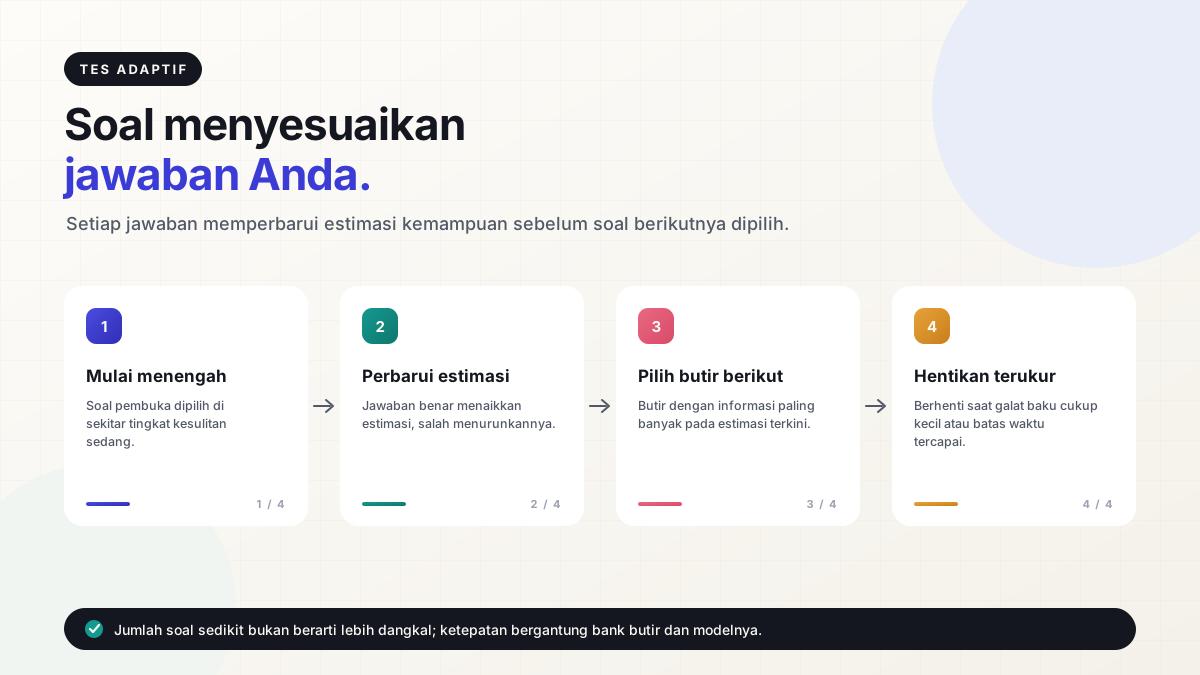
Satu jawaban, satu keputusan berikutnya
Tes konvensional menyajikan paket butir yang sama untuk semua orang. Tes adaptif memilih butir berikutnya setelah membaca jawaban sebelumnya.
Logikanya sederhana. Jika peserta menjawab benar butir berkesulitan sedang, butir berikutnya dinaikkan. Jika ia salah, butir berikutnya diturunkan. Sebagian besar butir yang dikerjakan akhirnya berada di sekitar batas kemampuan peserta.
Alasannya soal informasi. Butir yang jelas terlalu mudah tidak memberi tahu banyak tentang orang yang mengerjakannya. Butir yang jauh di atas kemampuan hanya menghasilkan tebakan. Tes adaptif memangkas kedua ujung itu, sehingga setiap butir punya peluang lebih besar memberi keterangan.
Bagan
SiklusSiklus pemilihan butir pada tes adaptif
Sajikan butir
Butir dipilih pada tingkat kesulitan yang dekat dengan estimasi kemampuan.
Baca jawaban
Benar menaikkan estimasi, salah menurunkannya.
Perbarui estimasi
Estimasi kemampuan dan ketidakpastiannya dihitung ulang.
Pilih butir berikutnya
Butir dengan informasi tertinggi pada estimasi terbaru.
Setelah langkah terakhir, siklus kembali ke langkah pertama.
Dasar hitungannya bukan skor mentah
Perhitungan pada tes adaptif bertumpu pada item response theory (IRT). Dalam kerangka ini, setiap butir punya parameter kesulitan dan daya beda yang diestimasi dari data kalibrasi. Parameter itu dipakai menghitung fungsi informasi butir pada tiap tingkat kemampuan.
Weiss (1982) merangkum gagasan dasarnya: dengan memilih butir berinformasi tinggi pada estimasi kemampuan terkini, tes dapat mencapai presisi tertentu dengan jumlah butir jauh lebih sedikit dibanding tes tetap.
Angka penghematan yang sering dikutip berkisar separuh panjang tes untuk presisi setara. Angka itu wajar sebagai gambaran umum, tetapi bergantung pada kualitas bank soal dan ketepatan estimasi awal. Bila ada penyedia mencantumkan klaim "50% lebih efisien" di brosur, perlakukan sebagai harapan, bukan jaminan.
Bank soal adalah batas keras
Tes adaptif tidak dapat memilih butir yang tidak tersedia. Bila bank soal hanya berisi butir pada rentang menengah, peserta dengan kemampuan sangat tinggi atau sangat rendah akan kehabisan pilihan yang sesuai.
Akibatnya terlihat di ujung distribusi. Untuk peserta ekstrem, tes adaptif berangsur berperilaku seperti tes biasa: butir yang disajikan terlalu mudah atau terlalu sulit, dan informasi per butir menurun. Ini alasan laporan yang baik mencantumkan berapa butir disajikan dan apakah batas panjang maksimum tercapai.
Ada persoalan teknis kedua, yaitu galat kalibrasi. Parameter butir diestimasi dari sampel kalibrasi, dan estimasi itu tidak pernah bersih. van der Linden dan Glas (2000) menunjukkan bahwa memakai parameter yang mengandung galat dapat menurunkan akurasi pemilihan butir, terutama pada bank soal kecil. Semakin kecil sampel kalibrasi, semakin besar kemungkinan butir yang dipilih meleset dari yang seharusnya.
Aturan berhenti dan panjang tes
Tes adaptif berhenti karena kriteria, bukan karena jumlah soal yang dipatok. Dua kriteria yang paling lazim adalah ambang presisi dan batas panjang.
Pada kriteria pertama, tes berhenti ketika galat baku estimasi sudah di bawah nilai tertentu. Peserta dengan pola jawaban konsisten mencapai ambang itu lebih cepat. Peserta yang jawabannya bersilangan butuh lebih banyak butir. Pada kriteria kedua, tes berhenti setelah sejumlah butir maksimum, demi melindungi peserta dari sesi tanpa ujung dan menjaga biaya.
Dua kriteria itu bisa bertabrakan. Bila batas panjang tercapai sebelum ambang presisi, hasil tetap dilaporkan, tetapi dengan rentang ketidakpastian lebih lebar. Laporan yang jujur menyebut kondisi ini. Laporan yang menyembunyikannya membuat angka terlihat lebih pasti daripada kenyataannya.
Perbandingan
Dua kriteria berhenti
| Ambang presisi | Batas panjang |
|---|---|
| Tes berhenti saat galat baku di bawah nilai tertentu | Tes berhenti setelah sejumlah butir maksimum |
| Peserta dengan pola jawaban konsisten mencapai ambang lebih cepat | Peserta yang jawabannya bersilangan butuh lebih banyak butir |
| Menjaga presisi hasil | Menjaga durasi sesi dan biaya |
Kontrol paparan butir
Bila pemilihan butir hanya mengejar informasi tertinggi, butir terbaik akan disajikan ke hampir semua peserta. Dalam hitungan bulan, isi tes beredar dan keamanannya hilang.
Karena itu penerapan praktis menambahkan aturan paparan. Chang dan Ying (1999) mengusulkan stratifikasi berdasarkan daya beda: butir dikelompokkan, lalu kelompok dipakai bergiliran agar butir kuat tidak habis pada peserta awal. Pendekatan lain membatasi laju pemakaian tiap butir per periode.
Aturan paparan menurunkan efisiensi sedikit. Itu pertukaran yang disengaja. Tes yang efisien tetapi bocor tidak berguna dalam jangka panjang.
Kapan tes adaptif justru merugikan
Tes adaptif bukan pilihan otomatis yang lebih baik. Ada kondisi ketika ia menambah kerumitan tanpa menambah manfaat.
Pertama, ketika jumlah peserta sangat kecil. Kalibrasi butir dan pemantauan paparan menuntut data yang cukup. Pada populasi puluhan orang per tahun, tes tetap dengan norma yang jelas biasanya lebih dapat dipertanggungjawabkan.
Kedua, ketika keputusan yang diambil bersifat kategoris dan ambangnya sudah jelas, misalnya lulus atau tidak lulus pada batas tertentu. Tes adaptif yang dirancang untuk skor kontinu perlu penyesuaian sebelum dipakai pada keputusan biner.
Ketiga, ketika peserta perlu melihat semua butir untuk alasan transparansi atau hukum. Pada beberapa konteks, keseragaman isi tes lebih penting daripada efisiensi.
Bagan
LangkahTiga kondisi ketika tes adaptif merugikan
Jumlah peserta sangat kecil
Kalibrasi butir dan pemantauan paparan menuntut data yang cukup.
Keputusan kategoris dengan ambang jelas
Rancangan skor kontinu perlu penyesuaian sebelum dipakai pada keputusan biner.
Peserta perlu melihat semua butir
Keseragaman isi tes kadang lebih penting daripada efisiensi.
Apakah tes adaptif cocok untuk klasifikasi?
Bisa, dengan rancangan khusus. Eggen dan Straetmans (2000) membandingkan pendekatan adaptif untuk menggolongkan peserta ke tiga kategori, dan menemukan bahwa aturan berhenti berbasis klasifikasi memberi hasil lebih efisien daripada aturan berhenti berbasis presisi skor.
Perbedaannya halus tetapi penting. Pada klasifikasi, pertanyaan yang dijawab bukan "berapa skor orang ini", melainkan "di sisi mana ambang ia berada". Butir yang paling berguna adalah butir di sekitar ambang, bukan butir yang paling informatif secara umum.
Meijer dan Nering (1999) mencatat bahwa penerapan adaptif menuntut kesiapan infrastruktur: bank soal terkalibrasi, perangkat lunak pemilihan butir, dan prosedur pemantauan berkelanjutan. Tanpa ketiganya, sistem adaptif hanya menambah lapisan teknis di atas tes biasa.
Contoh membaca laporan tes adaptif
Sebuah laporan menyebut: 41 butir disajikan, estimasi kemampuan pada skala logit, galat baku 0,31, batas panjang tidak tercapai.
Yang perlu diperiksa pertama adalah galat baku, bukan skornya. Angka 0,31 memberi gambaran seberapa lebar rentang tempat kemampuan sebenarnya mungkin berada. Bandingkan dengan galat baku yang biasa dilaporkan alat serupa.
Kedua, periksa apakah batas panjang tercapai. Kalau tercapai, hasilnya berada di batas desain, bukan di batas presisi.
Ketiga, periksa versi bank soal dan tanggal kalibrasi. Perubahan bank soal membuat skor lama tidak langsung sebanding dengan skor baru, meski konstruknya sama.
Untuk memahami mengapa rentang ketidakpastian itu penting, lihat standard error of measurement. Untuk dasar konversi skor, ada cara kerja norma dan glosarium CAT.
Batas interpretasi
Hasil tes adaptif bukan diagnosis dan bukan dasar tunggal keputusan seleksi. Ia estimasi posisi seseorang pada konstruk tertentu, dengan rentang kesalahan yang menyertainya.
Efisiensi tidak menghapus batas itu. Tes yang lebih pendek bukan berarti lebih pasti, dan skor dari 34 butir tidak otomatis lebih lemah daripada skor dari 60 butir bila keduanya mencapai galat baku yang sama.
Untuk alat yang dipakai berulang, pemantauan berkelanjutan lebih menentukan daripada desain adaptifnya. Tanpa pemantauan, penyimpangan kecil menumpuk tanpa terlihat sampai muncul keluhan dari peserta.
Pertanyaan yang sering diajukan
Apakah tes adaptif selalu lebih akurat?
Tidak selalu. Tes adaptif lebih efisien pada kondisi tertentu, tetapi akurasinya tetap bergantung pada kualitas bank soal, kalibrasi, dan aturan berhenti. Pada bank soal kecil, keunggulannya menyusut.
Mengapa dua peserta mengerjakan jumlah butir berbeda?
Karena butir dipilih berdasarkan jawaban sebelumnya. Peserta dengan pola jawaban konsisten mencapai ambang presisi lebih cepat, sehingga sesinya lebih pendek.
Apakah skor tes adaptif bisa dibandingkan dengan tes kertas?
Hanya bila keduanya dikalibrasi pada skala yang sama. Skor dari dua sistem berbeda tidak dapat dibandingkan langsung tanpa penyetaraan, meskipun konstruknya identik.
Apakah tes adaptif bisa dipakai tanpa pengawasan?
Secara teknis bisa, tetapi keamanan isi tes menjadi lebih rapuh karena butir yang sama dipakai lintas peserta dalam waktu berdekatan. Pembahasan soal itu ada di tes daring tanpa pengawasan.
Rujukan
- Chang, H.-H., & Ying, Z. (1999). a-Stratified multistage computerized adaptive testing. Applied Psychological Measurement, 23(3), 211–222. doi:10.1177/01466219922031338
- Eggen, T. J. H. M., & Straetmans, G. J. J. M. (2000). Computerized adaptive testing for classifying examinees into three categories. Educational and Psychological Measurement, 60(5), 713–734. doi:10.1177/00131640021970862
- Meijer, R. R., & Nering, M. L. (1999). Computerized adaptive testing: Overview and introduction. Applied Psychological Measurement, 23(3), 187–194. doi:10.1177/01466219922031310
- Thissen, D., & Wainer, H. (Eds.). (2001). Test Scoring. Lawrence Erlbaum Associates. doi:10.4324/9781410604729
- van der Linden, W. J., & Glas, C. A. W. (2000). Capitalization on item calibration error in adaptive testing. Applied Measurement in Education, 13(1), 35–53. doi:10.1207/s15324818ame1301_2
- Weiss, D. J. (1982). Improving measurement quality and efficiency with adaptive testing. Applied Psychological Measurement, 6(4), 473–492. doi:10.1177/014662168200600408
Penulis
Tim Riset sikotes.id
Editorial psikometri
Reviewer
Belum ditinjau psikolog
Konten edukatif umum
Sitasi halaman ini
Tim Riset sikotes.id. (2026). Tes Adaptif Komputer: Cara Kerja dan Kapan Ia Lebih Baik. sikotes.id. https://sikotes.id/artikel/tes-adaptif-komputer-cara-kerja-dan-batasnya
Boleh dikutip dengan atribusi. Lihat kebijakan AI & crawler.
Sumber & rujukan
Klaim dalam artikel ini dirujuk ke sumber primer berikut. Tautan membuka penerbit asli di tab baru.
Uji pemahaman Andalewat tes Anda sendiri.
Mulai dari tes gratis, lalu baca laporannya dengan kerangka yang dijelaskan di artikel ini. Metodologi dan batas interpretasi selalu ikut disertakan.
Baca juga
Artikel lain dengan topik atau kategori yang berdekatan, ditulis dan direview dengan standar yang sama.