Efek Langit-Langit: Ketika Tes Terlalu Mudah untuk Membedakan
Banyak peserta mendapat skor hampir sempurna, lalu tes kehilangan kemampuan membedakan. Ini yang disebut efek langit-langit, cara mendeteksinya, dan mengapa tes sulit juga punya masalah sebaliknya.
Ringkasan cepat
Banyak peserta mendapat skor hampir sempurna, lalu tes kehilangan kemampuan membedakan. Ini yang disebut efek langit-langit, cara mendeteksinya, dan mengapa tes sulit juga punya masalah sebaliknya.
Coba tesnya sekarang — tanpa mendaftar
Profil lima dimensi kepribadian: yang stabil, yang bisa berubah, dan yang sering disalahpahami.
- Jawaban langsung dinilai di server
- Tanpa email, tanpa nama
- Laporan lengkap dibuka dengan akun
- Tersimpan 30 hari untuk Anda klaim
Hasil adalah bahan refleksi, bukan diagnosis. Untuk membaca dan menyimpan laporan, masuk atau daftar setelah tes selesai — hasil yang sudah dikerjakan tidak hilang.
Sebuah sekolah mengadakan tes diagnostik matematika untuk kelas unggulan. Hasilnya mengejutkan panitia: 31% peserta menjawab semua butir dengan benar. Rata-rata kelas 92 dari 100. Ketua panitia menyimpulkan bahwa "siswa sudah sangat menguasai materi".
Kesimpulan itu bisa benar. Bisa juga tesnya hanya terlalu mudah untuk kelompok tersebut. Ketika banyak peserta menempel di batas atas, alat kehilangan kemampuan membedakan siapa yang benar-benar paling menguasai.
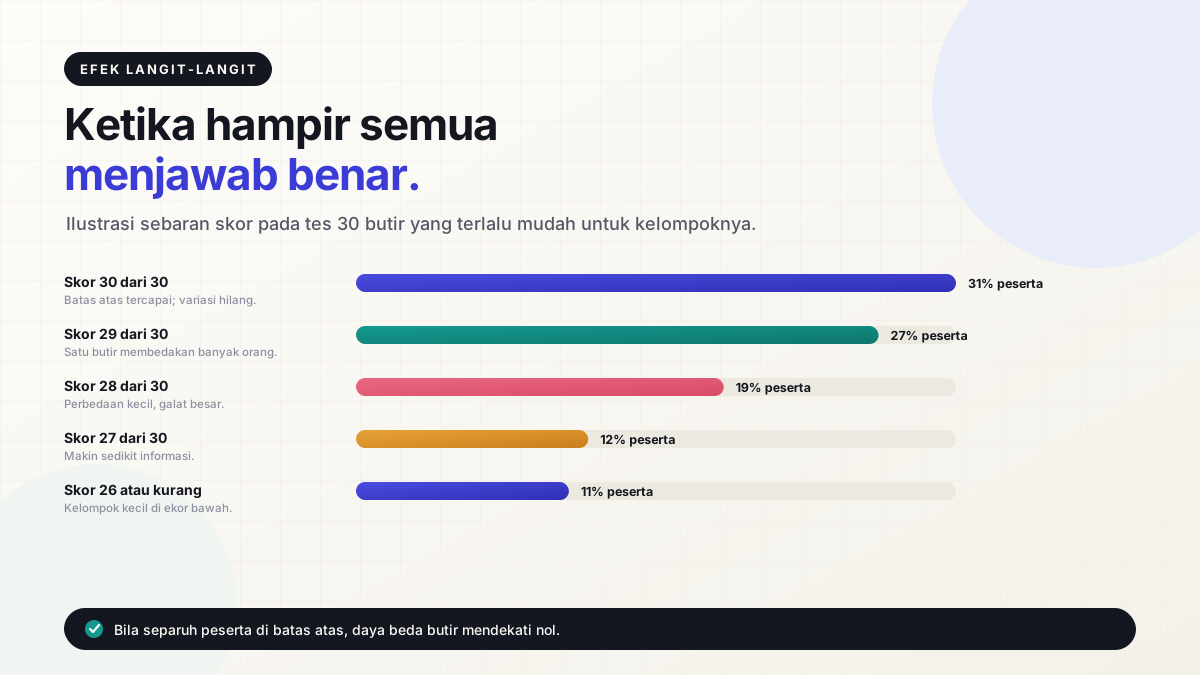
Apa itu efek langit-langit dan langit-lantai?
Efek langit-langit muncul ketika butir terlalu mudah sehingga banyak peserta memperoleh skor maksimum atau mendekati maksimum. Efek langit-lantai adalah kebalikannya: butir terlalu sulit sehingga banyak peserta menebak dan menempel di batas bawah.
Keduanya merusak hal yang sama, yaitu variasi skor yang bermakna. Pada titik ekstrem, tes tetap memberi angka, tetapi angka itu tidak lagi membedakan.
Bagan
MatriksEmpat kondisi tingkat kesulitan butir dan akibatnya
Kemampuan kelompok → tinggi
Butir sulit, kelompok rendah
- Tidak informatif untuk keduanya — Peserta menebak dan frustrasi.
Butir sulit, kelompok tinggi
- Daya beda baik — Informasi tersebar pada rentang yang relevan.
Butir mudah, kelompok rendah
- Langit-lantai, banyak tebakan — Daya beda hilang di ujung bawah.
Butir mudah, kelompok tinggi
- Terlalu mudah untuk keduanya — Langit-langit, hampir semua skor maksimum.
Tingkat kesulitan butir → tinggi
Mengapa variasi yang hilang itu masalah
Bayangkan dua siswa yang berbeda jauh dalam penguasaan materi, tetapi keduanya menjawab 20 dari 20. Setelah diskalakan, keduanya mendapat persentil yang sama. Perbedaan yang sebenarnya ada tidak terlihat sama sekali.
Dampak lanjutannya muncul di analisis. Korelasi antara skor tes dan nilai rapor melemah bukan karena tidak ada hubungan, melainkan karena skor tes kehilangan variasi. Dalam literatur seleksi, fenomena serumpun ini dibahas sebagai pembatasan rentang (range restriction) dan berpengaruh besar pada estimasi validitas (Sackett dkk., 2022).
Ada tiga akibat praktis:
- Daya beda butir turun. Butir yang dijawab benar oleh hampir semua orang hampir tidak memberi informasi tentang perbedaan kemampuan.
- Keputusan seleksi menjadi acak. Jika semua di atas ambang, pemeringkatan ditentukan oleh galat, bukan kompetensi.
- Estimasi validitas bias. Korelasi yang dilaporkan lebih kecil dari yang seharusnya, sehingga alat yang baik bisa terlihat buruk.
Bagaimana efek ini muncul pada tes kecepatan
Tes kecepatan seperti Kraepelin atau Pauli punya risiko serupa. Jika tugasnya mudah, perbedaan skor lebih banyak ditentukan kecepatan motorik dan pengalaman mengetik daripada daya tahan konsentrasi. Peserta yang sudah terbiasa mengetik akan unggul tanpa benar-benar lebih teliti.
Pada tes dengan batas waktu, langit-langit sering muncul bukan karena butir mudah, melainkan karena waktu terlalu longgar. Sebaliknya, waktu terlalu ketat menciptakan langit-lantai: banyak peserta tidak sempat menyelesaikan bagian akhir.
Cara mendeteksi dari laporan yang ada
Anda tidak perlu data mentah untuk mencurigai masalah ini. Beberapa tanda cukup jelas:
| Tanda | Arti praktis |
|---|---|
| Rata-rata di atas 85% dari skor maksimum | Kandidat kuat untuk langit-langit |
| Simpangan baku sangat kecil | Variasi antar peserta tipis |
| Lebih dari 15% peserta memperoleh skor maksimum | Butir terlalu mudah untuk kelompok itu |
| Distribusi menumpuk di satu ujung | Perlu tinjauan tingkat kesulitan butir |
| Banyak peserta menjawab "tidak tahu" pada tes sulit | Kemungkinan langit-lantai |
Pada laporan yang lebih teknis, lihat proporsi jawaban benar per butir. Butir dengan proporsi di atas 0,90 pada kelompok sasaran biasanya tidak banyak berkontribusi.
Satu catatan tambahan. Skor maksimum tidak selalu berarti butir terlalu mudah; bisa jadi kelompok pesertanya memang sangat terpilih. Karena itu, tanda-tanda di tabel di atas perlu dibaca bersama informasi tentang cara peserta direkrut. Kelas unggulan dengan 30% skor sempurna pada tes standar menandakan kebutuhan tes yang lebih sulit, bukan bukti bahwa tesnya cacat.
Mengapa tes mudah tetap dipakai
Alasannya jarang psikometris. Tes mudah memberi pengalaman menyenangkan bagi peserta, cepat selesai, dan menghasilkan banyak kelulusan yang membuat penyelenggara terlihat berhasil. Untuk tujuan pemetaan awal, tes mudah bisa berguna.
Masalahnya ketika alat yang sama dipakai untuk menyeleksi. Di titik itu, keputusan tidak lagi didukung data karena variasi sudah habis.
Apakah tes sulit selalu lebih baik?
Tidak. Tes yang terlalu sulit menciptakan langit-lantai, meningkatkan tebakan, dan membuat peserta frustrasi. Yang dibutuhkan bukan "sulit" atau "mudah", melainkan kecocokan antara tingkat kesulitan butir dan tingkat kemampuan kelompok sasaran.
Dalam kerangka item response theory, setiap butir punya kurva informasi. Butir paling informatif pada kisaran kemampuan tertentu. Tes yang baik menyusun butir sehingga informasi tersebar di sepanjang rentang yang relevan (Reise & Waller, 2009).
Apa yang bisa diperbaiki
Tambahkan butir sulit di atas level tertinggi kelompok. Cara paling langsung. Butir baru perlu diuji coba sebelum dipakai.
Perluas rentang sasaran. Jika tes dipakai untuk kelas unggulan, normanya juga harus dari kelompok setara.
Perlakukan skor maksimum sebagai kategori terbuka. Tulis "≥20 dari 20" dan hindari pemeringkatan di dalamnya.
Laporkan persentase skor maksimum. Satu baris di laporan sudah cukup untuk memberi sinyal kepada pembaca.
Perbaikan ini menuntut pekerjaan, tetapi jauh lebih murah daripada mengambil keputusan besar berdasarkan tes yang tidak lagi membedakan.
Hubungan dengan reliabilitas dan norma
Efek langit-langit dan reliabilitas saling terkait, meski tidak identik. Ketika variasi skor menyusut, koefisien reliabilitas yang dihitung dari sampel tersebut juga menurun, karena tidak ada perbedaan yang bisa dijelaskan.
Hal serupa terjadi pada norma. Norma yang dibangun dari kelompok dengan skor menumpuk di batas atas akan menghasilkan persentil yang berjauhan padahal selisih skornya satu butir. Satu jawaban benar bisa menggeser persentil 25 poin. Pembaca laporan jarang menyadari bahwa pergeseran itu artefak, bukan prestasi.
Karena itu, laporan yang baik menyertakan distribusi skor kelompok norma, bukan hanya tabel konversi. Distribusi memperlihatkan apakah persentil masih bermakna atau sudah kehabisan ruang.
Empat pertanyaan sebelum memakai tes
- Berapa persentase peserta yang memperoleh skor maksimum pada kelompok sasaran?
- Apakah simpangan baku cukup besar untuk membedakan peserta?
- Apakah ada butir yang sengaja disiapkan untuk tingkat kemampuan tertinggi?
- Apakah keputusan yang diambil menuntut pemeringkatan halus, atau cukup penggolongan kasar?
Jika jawaban pertanyaan keempat adalah "cukup penggolongan kasar", tes yang agak mudah masih dapat dipakai dengan aman. Jika tidak, penambahan butir sulit atau penggantian alat menjadi keharusan.
Batas interpretasi
Hasil tes bukan diagnosis dan bukan dasar tunggal seleksi. Skor yang menempel di batas atas atau bawah tidak bisa dijadikan bukti kompetensi tanpa bukti tambahan, misalnya portofolio, wawancara terstruktur, atau sampel kerja.
Untuk memahami istilah terkait, baca glosarium persentil dan glosarium computerized adaptive testing. Perbandingan alat bisa dilihat di daftar tes dan artikel reliabilitas. Untuk tes yang panjangnya menyesuaikan jawaban peserta, lihat tes adaptif komputer.
Pertanyaan yang sering diajukan
Apakah skor maksimum berarti peserta sangat mampu?
Bisa jadi, tetapi tidak selalu. Jika sebagian besar peserta juga memperoleh skor maksimum, tes tidak lagi membedakan. Skor maksimum baru bermakna jika disertai informasi bahwa butir cukup sulit bagi kelompok tersebut.
Berapa persen peserta yang boleh memperoleh skor maksimum?
Tidak ada ambang baku. Sebagai rambu praktis, lebih dari 15% peserta dengan skor sempurna pada kelompok sasaran biasanya menandakan perlunya peninjauan tingkat kesulitan. Angka ini bukan aturan resmi, melainkan pemicu pemeriksaan.
Apakah menambah butir sulit selalu memperbaiki tes?
Hanya jika butir baru diuji coba dan terbukti berfungsi baik. Butir yang terlalu sulit atau ambigu menambah galat, bukan informasi. Penambahan butir juga memperpanjang durasi dan meningkatkan kelelahan peserta.
Rujukan
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. Standar resmi
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology, 107(11), 2040–2068. doi:10.1037/apl0000994
- Reise, S. P., & Waller, N. G. (2009). Item response theory and clinical measurement. Annual Review of Clinical Psychology, 5(1), 27–48. doi:10.1146/annurev.clinpsy.032408.153553
- Kane, M. T. (2013). Validating the interpretations and uses of test scores. Journal of Educational Measurement, 50(1), 1–73. doi:10.1111/jedm.12000
- McNeish, D. (2018). Thanks coefficient alpha, we'll take it from here. Psychological Methods, 23(3), 412–433. doi:10.1037/met0000144
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. doi:10.1080/10705519909540118
Penulis
Tim Riset sikotes.id
Editorial psikometri
Reviewer
Belum ditinjau psikolog
Konten edukatif umum
Sitasi halaman ini
Tim Riset sikotes.id. (2026). Efek Langit-Langit: Ketika Tes Terlalu Mudah untuk Membedakan. sikotes.id. https://sikotes.id/artikel/efek-langit-langit-tes-terlalu-mudah
Boleh dikutip dengan atribusi. Lihat kebijakan AI & crawler.
Sumber & rujukan
Klaim dalam artikel ini dirujuk ke sumber primer berikut. Tautan membuka penerbit asli di tab baru.
Uji pemahaman Andalewat tes Anda sendiri.
Mulai dari tes gratis, lalu baca laporannya dengan kerangka yang dijelaskan di artikel ini. Metodologi dan batas interpretasi selalu ikut disertakan.
Baca juga
Artikel lain dengan topik atau kategori yang berdekatan, ditulis dan direview dengan standar yang sama.