Skala Likert: Titik Tengah, Akuiesens, dan Sumber Galat yang Sering Diabaikan
Titik tengah pada skala setuju tidak selalu netral, dan kecenderungan mengiyakan bukan sekadar sopan santun. Dua hal ini mengubah cara membaca data kuesioner.
Ringkasan cepat
Titik tengah pada skala setuju tidak selalu netral, dan kecenderungan mengiyakan bukan sekadar sopan santun. Dua hal ini mengubah cara membaca data kuesioner.
Coba tesnya sekarang — tanpa mendaftar
Profil lima dimensi kepribadian: yang stabil, yang bisa berubah, dan yang sering disalahpahami.
- Jawaban langsung dinilai di server
- Tanpa email, tanpa nama
- Laporan lengkap dibuka dengan akun
- Tersimpan 30 hari untuk Anda klaim
Hasil adalah bahan refleksi, bukan diagnosis. Untuk membaca dan menyimpan laporan, masuk atau daftar setelah tes selesai — hasil yang sudah dikerjakan tidak hilang.
Dua responden memberi jawaban yang sama pada sepuluh butir kepuasan. Yang satu benar-benar puas. Yang lain hanya enggan menekan kotak "tidak setuju". Skor keduanya identik, dan skor itu tidak membedakan keduanya.
Kuesioner jarang gagal karena pertanyaannya salah. Ia lebih sering gagal karena skalanya memaksa orang menjawab dengan cara tertentu.
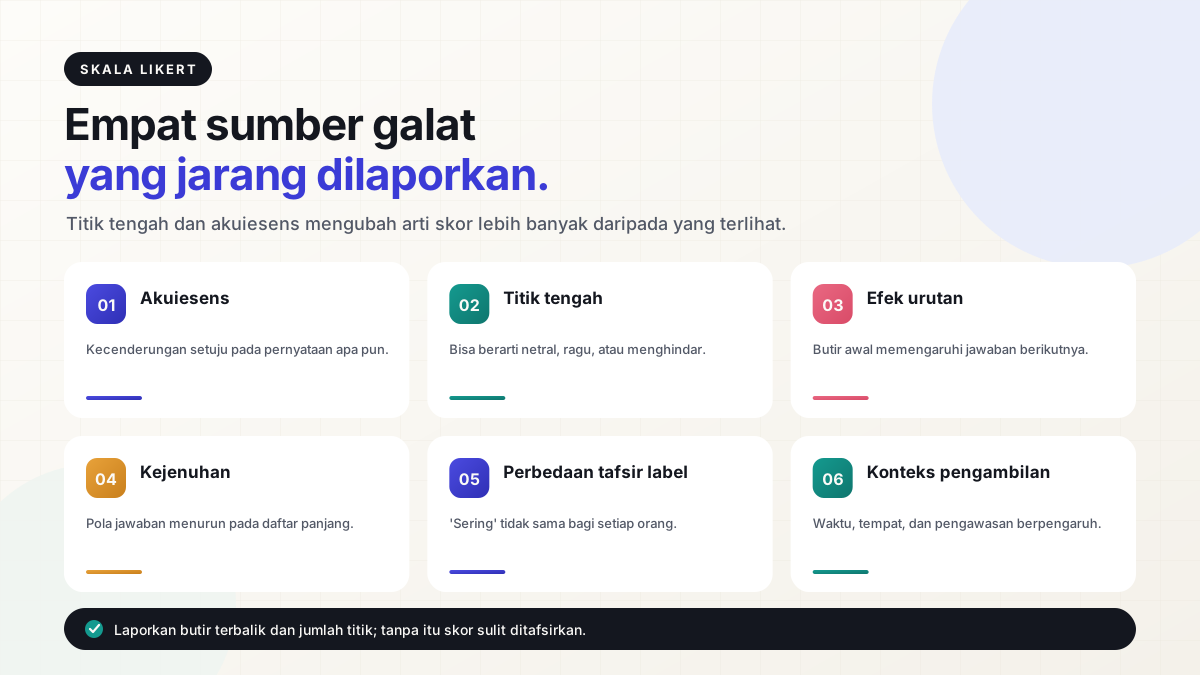
Titik tengah bukan titik netral
Skala setuju lima titik lazim dianggap punya tengah yang netral. Anggapan itu tidak sepenuhnya benar.
Nadler, Weston, dan Voyles (2015) meninjau pemakaian titik tengah dan menemukan bahwa responden memaknainya berbeda-beda: sebagian sebagai "tidak tahu", sebagian sebagai "netral", sebagian sebagai "tidak berpendapat", dan sebagian sebagai jalan keluar dari pertanyaan yang membingungkan.
Artinya, satu kotak tengah menampung setidaknya empat keadaan psikologis yang berbeda. Ketika peneliti merata-ratakan skor, keempat keadaan itu melebur menjadi satu angka yang sama.
Ada pilihan desain yang lebih tegas. Bila Anda memang ingin memaksa responden memilih arah, hilangkan titik tengah dan terima konsekuensinya: sebagian responden akan memilih secara acak. Bila Anda ingin menangkap keraguan, pertahankan titik tengah dan tambahkan kategori "tidak tahu" yang terpisah.
Akuiesens dan ekstremitas
Cronbach (1950) mendokumentasikan apa yang ia sebut response sets: kecenderungan menjawab yang tidak berkaitan dengan isi pertanyaan. Dua yang paling sering muncul adalah akuiesens, yaitu kecenderungan menyetujui, dan ekstremitas, yaitu kecenderungan memilih ujung skala.
Akuiesens bukan tanda responden tidak jujur. Ia sering merupakan hasil dari butir yang ditulis dengan arah sama semua. Kuesioner yang sepuluh butirnya semuanya berbunyi "saya merasa..." dalam bentuk positif akan menghasilkan korelasi tinggi antar butir yang sebagian berasal dari kebiasaan menjawab, bukan dari konstruk.
Perbaikan yang lazim adalah mencampur arah butir. Namun penulisan butir terbalik menimbulkan masalah baru: butir negasi lebih sulit dipahami, dan sebagian responden melewatkan kata "tidak" di tengah kalimat. Kesalahan itu muncul sebagai skor yang aneh, bukan sebagai jawaban kosong.
Perbandingan
Dua gaya menjawab yang bukan isi jawaban
| Akuiesens | Ekstremitas |
|---|---|
| Kecenderungan menyetujui butir apa pun | Kecenderungan memilih ujung skala |
| Sering muncul karena semua butir ditulis searah | Memengaruhi lebar sebaran jawaban |
| Ditekan dengan mencampur arah butir | Terlihat saat memeriksa sebaran jawaban |
Berapa jumlah pilihan yang wajar
Weijters, Cabooter, dan Schillewaert (2010) menguji pengaruh jumlah kategori jawaban dan pemberian label terhadap gaya menjawab. Temuan praktisnya: skala dengan lebih banyak kategori cenderung memperbesar pengaruh gaya menjawab, sedangkan label kata pada setiap titik menekan sebagian pengaruh itu.
Untuk kuesioner lapangan, skala lima atau tujuh titik dengan label penuh pada tiap titik biasanya merupakan titik seimbang. Skala sebelas titik tanpa label hanya masuk akal bila responden terlatih dan pengambilan datanya terkendali.
Jumlah titik juga memengaruhi sebaran. Skala empat titik tanpa tengah memaksa pilihan ke satu arah dan menghasilkan sebaran lebih lebar, tetapi menaikkan jumlah jawaban asal.
Mengapa dua kuesioner berisi sama bisa berbeda hasil
Dua tim menyusun kuesioner dengan daftar pertanyaan yang mirip. Hasilnya berbeda cukup jauh, dan tidak ada yang salah pada isi pertanyaan.
Penyebabnya biasanya tiga. Pertama, urutan butir. Butir tentang beban kerja yang diletakkan tepat sebelum butir tentang kepuasan atasan akan menarik jawaban ke arah negatif, karena pikiran responden masih berada di keluhan yang baru saja diingat.
Kedua, panjang blok tanpa jeda. Responden yang menjawab 40 butir berturut-turut dalam satu layar mulai menjawab dengan pola, misalnya selalu memilih kotak ketiga. Jeda, halaman baru, atau pengelompokan per tema mengurangi pola itu.
Ketiga, kalimat pengantar. Instruksi yang menekankan "jawab sejujurnya, tidak ada jawaban benar" menaikkan variasi jawaban. Instruksi yang menekankan "jawaban Anda akan dilaporkan kepada atasan" menurunkannya, sekaligus menurunkan kejujuran.
Tidak satu pun dari ketiganya terlihat di tabel hasil. Karena itu, membandingkan dua survei dari dua penyedia menuntut pengetahuan tentang konstruksi kuesionernya, bukan hanya tentang daftar pertanyaannya.
Bagan
LangkahTiga sebab hasil berbeda pada kuesioner yang mirip
Urutan butir
Butir tentang keluhan yang diletakkan lebih dulu menarik jawaban berikutnya ke arah negatif.
Panjang blok tanpa jeda
Responden mulai menjawab dengan pola yang sama.
Kalimat pengantar
Instruksi tentang kerahasiaan mengubah variasi dan kejujuran jawaban.
Apakah data ordinal boleh dirata-ratakan?
Pertanyaan ini masih diperdebatkan, dan jawabannya bergantung pada apa yang ingin disimpulkan.
Secara teknis, jarak antara "setuju" dan "sangat setuju" belum tentu sama dengan jarak antara "netral" dan "setuju". Menghitung rata-rata mengasumsikan jarak itu sama.
Rhemtulla, Brosseau-Liard, dan Savalei (2012) menunjukkan bahwa memperlakukan data kategori sebagai kontinu masih dapat memberi hasil yang wajar pada kondisi tertentu, terutama bila jumlah kategori cukup banyak dan sebarannya tidak terlalu menceng. Pada skala dengan tiga atau empat titik dan sebaran menceng, pemodelan kategori lebih tepat.
Konsekuensi praktisnya sederhana. Untuk laporan kelompok, rata-rata skala lima titik masih dapat dipakai sebagai ringkasan, asalkan disertai sebaran. Untuk keputusan individual berisiko tinggi, rata-rata tanpa interval bukan dasar yang memadai.
Label angka atau label kata
Skala yang hanya memberi label pada ujung, misalnya "1 = sangat tidak setuju" dan "5 = sangat setuju", membebani responden menafsirkan titik tengah sendiri. Penafsiran itu bervariasi antar orang dan antar budaya.
Label penuh mengurangi variasi itu, tetapi menambah panjang tampilan. Pada kuesioner ponsel, label penuh pada lima titik berarti teks yang harus dibaca berulang di setiap butir. Banyak penyedia akhirnya memilih label ujung saja dan menaruh keterangan di atas blok pertanyaan.
Mana pun yang dipilih, konsistensi lebih penting daripada pilihan itu sendiri. Mengubah format label di tengah rangkaian pengukuran membuat perbandingan antar waktu kehilangan dasar.
Apakah butir terbalik selalu perlu?
Tidak selalu. Butir terbalik berguna menekan akuiesens, tetapi menambah beban kognitif dan sumber galat baru.
Untuk alat pendek, misalnya lima butir, satu atau dua butir terbalik sudah cukup. Untuk alat panjang, proporsi seimbang lebih aman. Yang perlu dihindari adalah butir terbalik yang mengandung negasi ganda, misalnya "saya tidak pernah merasa tidak mampu". Butir seperti itu mengukur kemampuan membaca kalimat, bukan konstruk yang dituju.
Joshi dan rekan-rekannya (2015) merangkum praktik penyusunan skala Likert dan menekankan hal yang sama: kejelasan kalimat lebih menentukan mutu data daripada kecanggihan analisis sesudahnya.
Contoh membaca hasil yang tampak baik
Sebuah survei kepuasan kerja melaporkan rata-rata 4,12 dari 5 pada dimensi "dukungan atasan". Angkanya terlihat bagus hingga diperiksa sebarannya: 61% responden memilih 4, dan sisanya memilih 5 atau 3, tanpa satu pun memilih 1 atau 2.
Sebaran seperti itu sering menandakan pertanyaan yang tidak berani dijawab jujur, bukan tempat kerja yang nyaris sempurna. Bila survei dikumpulkan atasan langsung, atau bila jumlah responden per unit sangat kecil sehingga jawaban mudah dilacak, kecenderungan memberi nilai tinggi meningkat.
Yang lebih informatif: membandingkan sebaran antar unit, memeriksa butir yang paling banyak dijawab "netral", dan menanyakan ulang sebagian responden secara lisan. Untuk pembahasan soal kerahasiaan kelompok kecil, lihat data kesehatan karyawan.
Batas interpretasi
Skor skala Likert bukan diagnosis dan bukan dasar tunggal keputusan tentang individu. Ia ringkasan jawaban yang dipengaruhi isi pertanyaan, format skala, dan cara pengumpulan.
Untuk pemakaian yang lebih serius, glosarium skala Likert merangkum istilah dasarnya, dan artikel reliabilitas menjelaskan mengapa konsistensi internal saja belum cukup.
Pertanyaan yang sering diajukan
Apakah skala Likert harus selalu lima titik?
Tidak ada aturan baku. Lima dan tujuh titik paling lazim karena cukup halus tanpa membebani responden. Yang lebih menentukan adalah pemberian label dan konsistensi format antar butir.
Bolehkah titik tengah dihilangkan?
Boleh, bila tujuannya memaksa responden memilih arah. Konsekuensinya, sebagian jawaban akan diberikan secara asal, dan kelompok yang benar-benar netral tidak lagi terwakili.
Mengapa skor saya berubah setelah butir terbalik dibalik?
Karena butir terbalik dijumlahkan dengan arah berlawanan. Bila pembalikan terlewat, skor total menjadi tidak bermakna meski angkanya terlihat wajar.
Apakah rata-rata skala Likert boleh dilaporkan?
Boleh sebagai ringkasan kelompok, asalkan disertai sebaran dan jumlah responden. Untuk keputusan individual, rata-rata tanpa rentang ketidakpastian bukan dasar yang memadai.
Rujukan
- Cronbach, L. J. (1950). Further evidence on response sets and test design. Educational and Psychological Measurement, 10(1), 3–31. doi:10.1177/001316445001000101
- Joshi, A., Kale, S., Chandel, S., & Pal, D. K. (2015). Likert scale: Explored and explained. British Journal of Applied Science & Technology, 7(4), 396–403. doi:10.9734/BJAST/2015/14975
- Nadler, J. T., Weston, R., & Voyles, E. C. (2015). Stuck in the middle: The use and interpretation of mid-points in items on questionnaires. The Journal of General Psychology, 142(2), 71–89. doi:10.1080/00221309.2014.994590
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. doi:10.1037/a0029315
- Weijters, B., Cabooter, E., & Schillewaert, N. (2010). The effect of rating scale format on response styles: The number of response categories and response category labels. International Journal of Research in Marketing, 27(2), 91–106. doi:10.1016/j.ijresmar.2010.02.004
Penulis
Tim Riset sikotes.id
Editorial psikometri
Reviewer
Belum ditinjau psikolog
Konten edukatif umum
Sitasi halaman ini
Tim Riset sikotes.id. (2026). Skala Likert: Titik Tengah, Akuiesens, dan Sumber Galat yang Sering Diabaikan. sikotes.id. https://sikotes.id/artikel/skala-likert-titik-tengah-dan-akuiesens
Boleh dikutip dengan atribusi. Lihat kebijakan AI & crawler.
Sumber & rujukan
Klaim dalam artikel ini dirujuk ke sumber primer berikut. Tautan membuka penerbit asli di tab baru.
Uji pemahaman Andalewat tes Anda sendiri.
Mulai dari tes gratis, lalu baca laporannya dengan kerangka yang dijelaskan di artikel ini. Metodologi dan batas interpretasi selalu ikut disertakan.
Baca juga
Artikel lain dengan topik atau kategori yang berdekatan, ditulis dan direview dengan standar yang sama.